 Grow-beat
프롬프트 작성법, AI에 원하는 답을 요청하는 법
AI에 목표·배경·답변 형식을 적는 방법과 복사해서 쓸 예시입니다. 2026년 10월 자료를 바탕으로 모델별 지시 차이와 틀린 답을 확인하는 절차를 정리했습니다.
ChatGPT·Claude·Gemini에 보고서나 분석, 콘텐츠 기획을 맡기는 실무자를 위한 글입니다.
답이 얕거나 그럴듯한 오답이 섞여 다시 확인한 적이 있을 겁니다. '이 한 줄만 넣으면 정확도가 오른다'는 문구가 지금도 통하는지도 헷갈리고요.
Anthropic·OpenAI·Google 공식 가이드와 원 논문을 직접 확인해 2026년 10월 기준으로 통하는 작성법, 버릴 옛 기법, 복사용 프롬프트 2개를 정리했습니다.
AI가 더 깊이 생각하고 정확하게 답하게 하려면 무엇부터 바꿔야 하나요?
2026년 10월 기준 Anthropic·OpenAI·Google 공식 가이드는 마법 같은 한 줄보다 목표·맥락·출력 형식을 분명히 적으라고 공통으로 권합니다. 생각의 깊이는 문구보다 모델의 추론 설정이 우선이고, 필요하면 짧은 요청을 보탭니다.
Anthropic은 Claude를 '똑똑하지만 맥락을 모르는 신입 직원'처럼 대하라고 설명합니다. '말줄임표 금지'보다 '음성 엔진이 읽을 글이라 말줄임표를 쓰지 말라'처럼 이유를 붙이면 모델이 규칙을 넓혀 적용한다는 것입니다.
| 모델별로 버릴 옛 기법 | 적용 모델(공식 안내 기준) | 대신 쓸 방법 |
|---|---|---|
| 단계별로 생각하라는 지시와 단계 대본 | 추론(thinking) 기능이 켜진 모델 | 추론 설정 조정, 필요하면 짧은 깊이 요청 |
| 경력·팁·위협 같은 감정 호소 | 모델 공통(효과 재현 안 됨) | 결과물이 쓰이는 곳과 이유 한 문장 |
| 대문자 강조와 '반드시' 남발 | Claude Opus 4.5·4.6 이후 | 평범한 지시문 |
| 모든 답에 붙이는 검증 지시 | Claude Opus 5 이후 | 사실이 중요한 작업에만 인용과 검증 |
API로 같은 프롬프트를 매일 돌리는 팀은 지금 표 왼쪽 문구를 걷어 내고 결과를 비교하세요. 앱에서 가끔 쓰는 개인은 아래 템플릿 2개만 저장해 두면 됩니다.
XML 태그와 예시는 프롬프트에 어떻게 넣어야 하나요?
지시·배경·자료를 XML 태그(꺾쇠괄호로 감싼 이름표)로 나누면 모델이 명령과 자료를 덜 헷갈립니다. Anthropic은 내용별 태그가 오해를 줄인다고 안내하고, OpenAI와 Google도 XML 태그나 마크다운 구분자를 권합니다.
태그 이름은 직접 정하되 일관되게 쓰고, Gemini에는 Google 권고대로 XML과 마크다운 중 하나만 쓰세요.
긴 문서는 자료를 위에, 질문을 맨 끝에 두세요. Anthropic은 이 배치로 자체 테스트에서 응답 품질이 최대 30% 좋아졌다고 밝혔지만, 세부 조건은 문서에 나오지 않습니다.
예시(원하는 입력과 출력의 짝)는 Anthropic이 3~5개를 권하고, Google은 너무 많으면 답이 예시를 베끼는 과적합을 경고합니다. OpenAI는 추론 모델에 먼저 예시 없이 써 보라고 합니다.
<context>
이 분석은 다음 주 대표 보고에 들어가고, 대표는 숫자보다 다음 달 할 일을 먼저 봅니다.
</context>
<data>
(캠페인 결과표나 문서를 붙여 넣기)
</data>
<task>
1. 성과가 가장 좋은 채널과 나쁜 채널을 하나씩 고르세요.
2. 각 이유를 data 안의 숫자로만 설명하세요.
3. 다음 달에 해 볼 일 3가지를 우선순위대로 제안하세요.
</task>
<output_format>
결론 3줄, 근거 표, 제안 목록 순서로 쓰고 data에 없는 내용은 "자료 없음"이라고 쓰세요.
</output_format>
'단계별로 생각해'는 최신 추론 모델에도 효과가 있나요?
대체로 필요 없습니다. 2026년 10월 기준 OpenAI는 추론 모델(답하기 전 내부에서 생각 단계를 거치는 모델)에 'think step by step' 지시가 불필요하고 방해될 수도 있다고 안내하고, Google도 Gemini 2.5·3 계열은 답변에 추론 단계를 쓰게 할 필요가 대체로 없다고 설명합니다.
흔히 도는 '정확도 34%→80%'와 맞는 1차 출처는 Google DeepMind의 2023년 OPRO 논문입니다. PaLM 2-L이 초등 수학 문제 GSM8K에서 지시문 없이 34.0%, '심호흡하고 단계별로 풀자'는 뜻의 영어 문구로 80.2%를 냈습니다. 그 모델에 맞춰 자동으로 찾은 문구라, 같은 논문에서도 채점 모델이 바뀌면 최고 문구가 달라졌습니다.
2025년 6월 와튼 스쿨 연구팀이 o3-mini·o4-mini·Gemini 2.5 Flash에 단계별 사고를 요청하자 평균 정확도 변화는 −3.3%p~+3.1%p로 작았고 응답 시간은 20~80% 늘었습니다.
Anthropic도 손으로 짠 단계 계획보다 '충분히 생각하라'는 일반 지시가 나은 경우가 많다고 하며, Claude Opus 5.5 같은 최신 모델은 추론을 thinking 태그로 써 내라는 옛 요청을 거절할 수 있다고 밝힙니다.
생각의 깊이는 Claude의 effort, OpenAI의 reasoning.effort, Gemini의 thinking_level 같은 API 설정으로 조절합니다. 다만 OpenAI는 이 설정을 품질 회복의 첫 수단으로 보지 말라고 하니, 지시부터 분명히 고친 뒤 올리세요.
'경력에 중요하다' 같은 감정 호소는 정말 효과가 있나요?
2023년 연구에서는 효과가 보고됐지만 같은 문구를 8개 조건 중 하나로 시험한 2025년 8월 와튼 스쿨 보고서에서는 5개 모델의 정확도가 의미 있게 오르지 않았습니다. 지금은 감정 대신 결과물이 쓰이는 곳과 이유를 적는 편이 공식 가이드에 맞습니다.
출발점은 2023년 7월 중국과학원·Microsoft 등 연구진의 EmotionPrompt 논문입니다. '내 경력에 매우 중요하다' 같은 감정 문장을 붙여 시험 세트 BIG-Bench에서 115%, Instruction Induction에서 8.00%의 상대 개선과 106명 평가 기준 10.9% 개선을 보고했지만, ChatGPT·GPT-4 등 2023년 모델 기준입니다.
와튼 연구팀은 이 경력 문구를 포함한 감정·팁·위협 문구 8종을 GPT-4o·o4-mini 등 5개 모델로 다시 시험했습니다. 박사급 문제(GPQA Diamond)와 공학 문제(MMLU-Pro)에서 한 모델의 한 조건을 빼면 의미 있는 개선이 없었고, 문항별로는 최대 36%p 오르거나 35%p 떨어져 예측이 어려웠습니다.
Google은 Gemini 3에 지나치게 설득하는 표현을 피하라고 하고, Anthropic은 Claude Opus 4.5·4.6에 '반드시 이 도구를 써라' 같은 강한 표현이 과잉 반응을 낳을 수 있다고 안내합니다. 감정 문구 대신 '투자자 자료에 들어가니 없는 수치는 만들지 마세요'처럼 이유를 적으세요.
그럴듯한 오답을 줄이는 검증 루프는 어떻게 쓰나요?
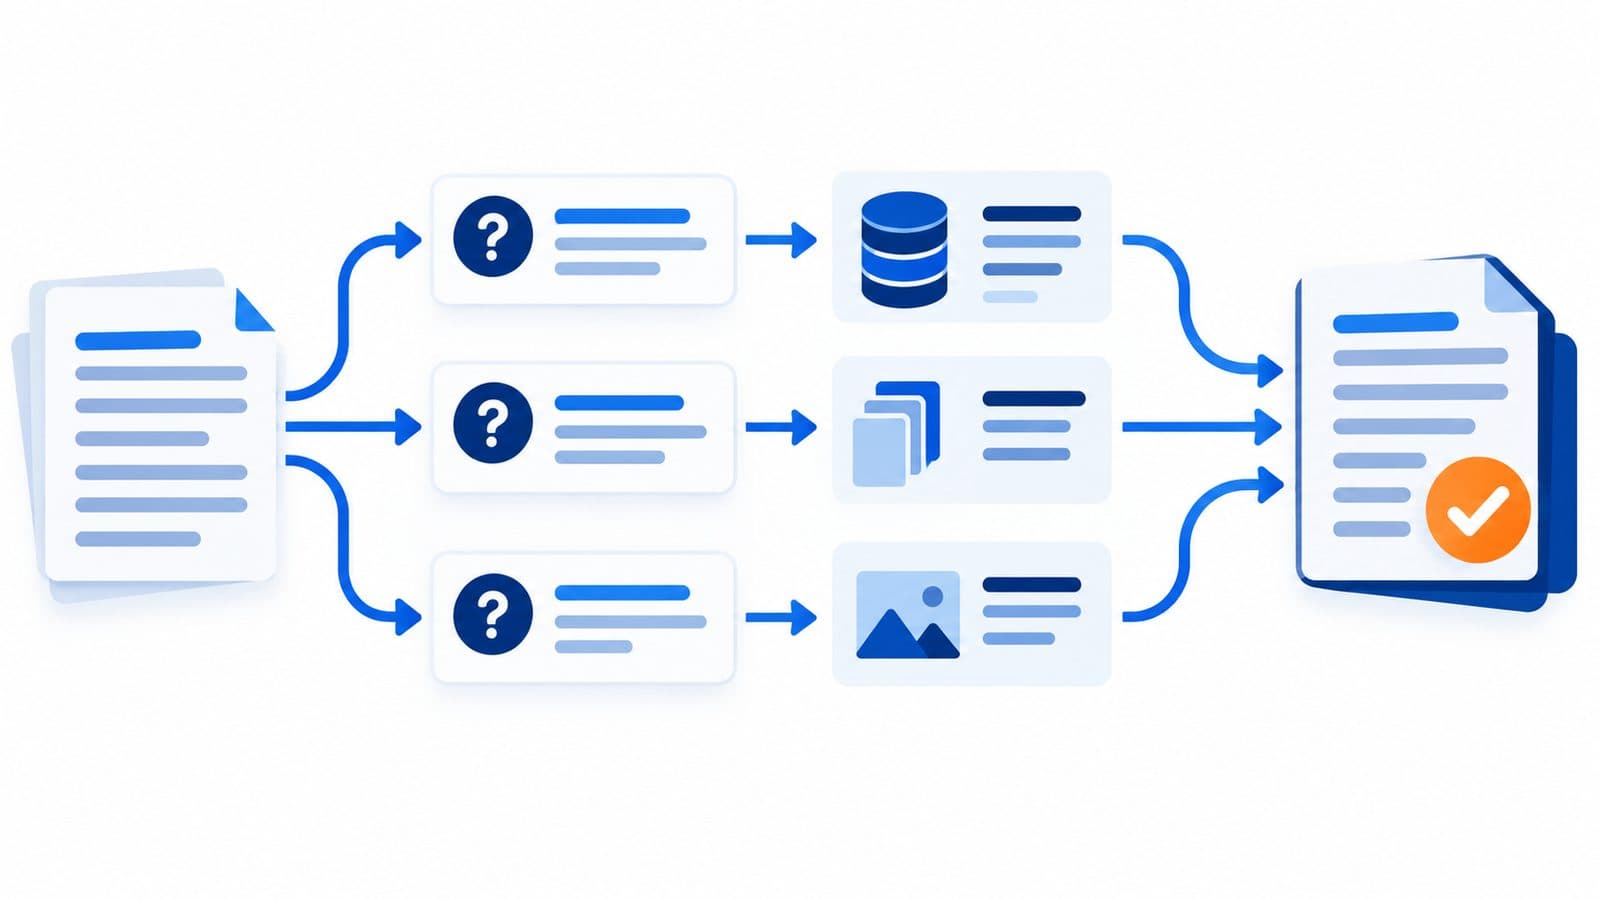
초안을 쓰게 한 뒤 사실 주장마다 확인 질문을 만들어 따로 답하게 하고, 근거 없는 주장은 지우게 하는 방식입니다. 2023년 9월 Meta AI 연구진의 Chain-of-Verification(CoVe) 논문은 이 4단계로 세 종류의 과제에서 환각(사실처럼 들리는 오답)이 줄었다고 보고했습니다.
같은 논문에서 3단계를 초안과 분리해 따로 답하게 한 방식이 세 과제 모두에서 더 나았습니다. 초안이 보이면 모델이 자기 오류를 되풀이하기 쉽기 때문입니다. 논문 스스로도 환각이 줄었을 뿐 사라지지는 않았고 계산 비용이 늘었다고 한계를 밝힙니다.
<documents>
(근거 자료를 붙여 넣기)
</documents>
위 자료만 근거로 답하세요. 질문: (질문 입력)
1. 관련 문장을 자료에서 그대로 뽑아 번호를 붙여 <quotes></quotes> 안에 적으세요.
2. 인용만 근거로 초안을 쓰세요.
3. 초안의 사실 주장마다 확인 질문을 만들고 자료를 다시 읽어 답하세요.
4. 확인 결과와 어긋나거나 인용 근거가 없는 주장은 지우고 [근거 없음]으로 표시한 최종 답을 쓰세요.
자료로 판단할 수 없으면 그렇다고 답해도 됩니다.3단계의 확인 질문만 자료와 함께 새 대화창에 붙여 넣어 답하게 하세요. 앱에서 CoVe의 분리 방식을 그대로 쓰는 방법입니다.
다만 Anthropic은 스스로 잘 검증하는 Claude Opus 5에서는 옛 검증 지시가 비용과 시간만 늘릴 수 있다며 빼라고 안내합니다. 검증 루프는 숫자·인용이 중요한 작업에만 쓰세요. 자료를 AI가 직접 찾아오게 하는 방법은 MCP가 AI 할루시네이션을 막는 이유에서 다뤘습니다.
자주 묻는 질문
'단계별로'라는 말은 아예 쓰면 안 되나요?
작업 순서를 알려 주는 번호 목록은 Anthropic도 권하는 방식이라 계속 써도 됩니다. 피할 것은 모델의 생각 과정을 대신 짜 주는 대본입니다.
추론 강도를 최대로 올리면 항상 더 정확한가요?
그렇지 않습니다. OpenAI는 xhigh를 평가로 이득이 확인될 때만 쓰라고 하고, Anthropic도 Claude Opus 4.7의 max는 대부분 작업에서 비용 대비 품질 이득이 작다고 안내합니다. 기본값부터 같은 질문으로 비교하세요.
XML 태그는 ChatGPT나 Gemini 앱에서도 써도 되나요?
네. 태그는 평범한 텍스트라 어느 대화창에나 붙여 넣을 수 있습니다. 위 템플릿도 괄호 안만 바꿔 그대로 쓰면 됩니다.
참고 자료
- ▸Anthropic, 「Prompting best practices」(2026-10-22) — https://platform.claude.com/docs/en/build-with-claude/prompt-engineering/claude-prompting-best-practices
- ▸OpenAI, 「Reasoning best practices」(2026-10-22) — https://developers.openai.com/api/docs/guides/reasoning-best-practices
- ▸Google, 「Prompt design strategies」(2026-10-13) — https://ai.google.dev/gemini-api/docs/prompting-strategies
- ▸Google DeepMind, 「Large Language Models as Optimizers」(2023-09-07) — https://arxiv.org/abs/2309.03409
- ▸와튼 스쿨, 「Prompting Science Report 3: I'll pay you or I'll kill you -- but will you care?」(2025-08-01) — https://arxiv.org/abs/2508.00614
- ▸Meta AI, 「Chain-of-Verification Reduces Hallucination in Large Language Models」(2023-09-20) — https://arxiv.org/abs/2309.11495
- ▸OpenAI, 「Reasoning models」(2026-10-22 확인) — https://developers.openai.com/api/docs/guides/reasoning
- ▸Anthropic, 「Effort」(2026-10-22 확인) — https://platform.claude.com/docs/en/build-with-claude/effort
- ▸arXiv, 「Prompting Science Report 3」(2025-08) — https://arxiv.org/abs/2508.00614
함께 읽으면 좋은 글
프롬프트 · 원리 글을 먼저, 그다음 최신 글을 보여 드려요
UI 애니메이션 프롬프트, DesignBookmark 사용법
UI 애니메이션 프롬프트를 모아 둔 DesignBookmark Motion 사용법입니다. 예제를 내 사이트에 넣는 순서와 이용 조건 확인법을 보고 시작하세요.
MCP, AI에 문서와 외부 도구를 연결하는 방식
MCP는 AI를 문서·외부 도구와 연결하는 규격입니다. 자료를 찾고 읽는 흐름을 살펴봅니다. 연결만으로 잘못된 답변이 없어지는 것은 아닙니다.
챗GPT 스페이스 Plus 확대, 페이지 공유 전 확인할 조건
챗GPT 스페이스가 2026년 11월 20일부터 Plus 요금제로 넓어지기 시작했습니다. 무료 계정 열람 제한, 공유 권한, 학습 설정을 확인하고 써 보세요.